Text Generation
fastText
Wayuu
wikilangs
nlp
tokenizer
embeddings
n-gram
markov
wikipedia
feature-extraction
sentence-similarity
tokenization
n-grams
markov-chain
text-mining
babelvec
vocabulous
vocabulary
monolingual
family-american_arawak
Instructions to use wikilangs/guc with libraries, inference providers, notebooks, and local apps. Follow these links to get started.
- Libraries
- fastText
How to use wikilangs/guc with fastText:
from huggingface_hub import hf_hub_download import fasttext model = fasttext.load_model(hf_hub_download("wikilangs/guc", "model.bin")) - Notebooks
- Google Colab
- Kaggle
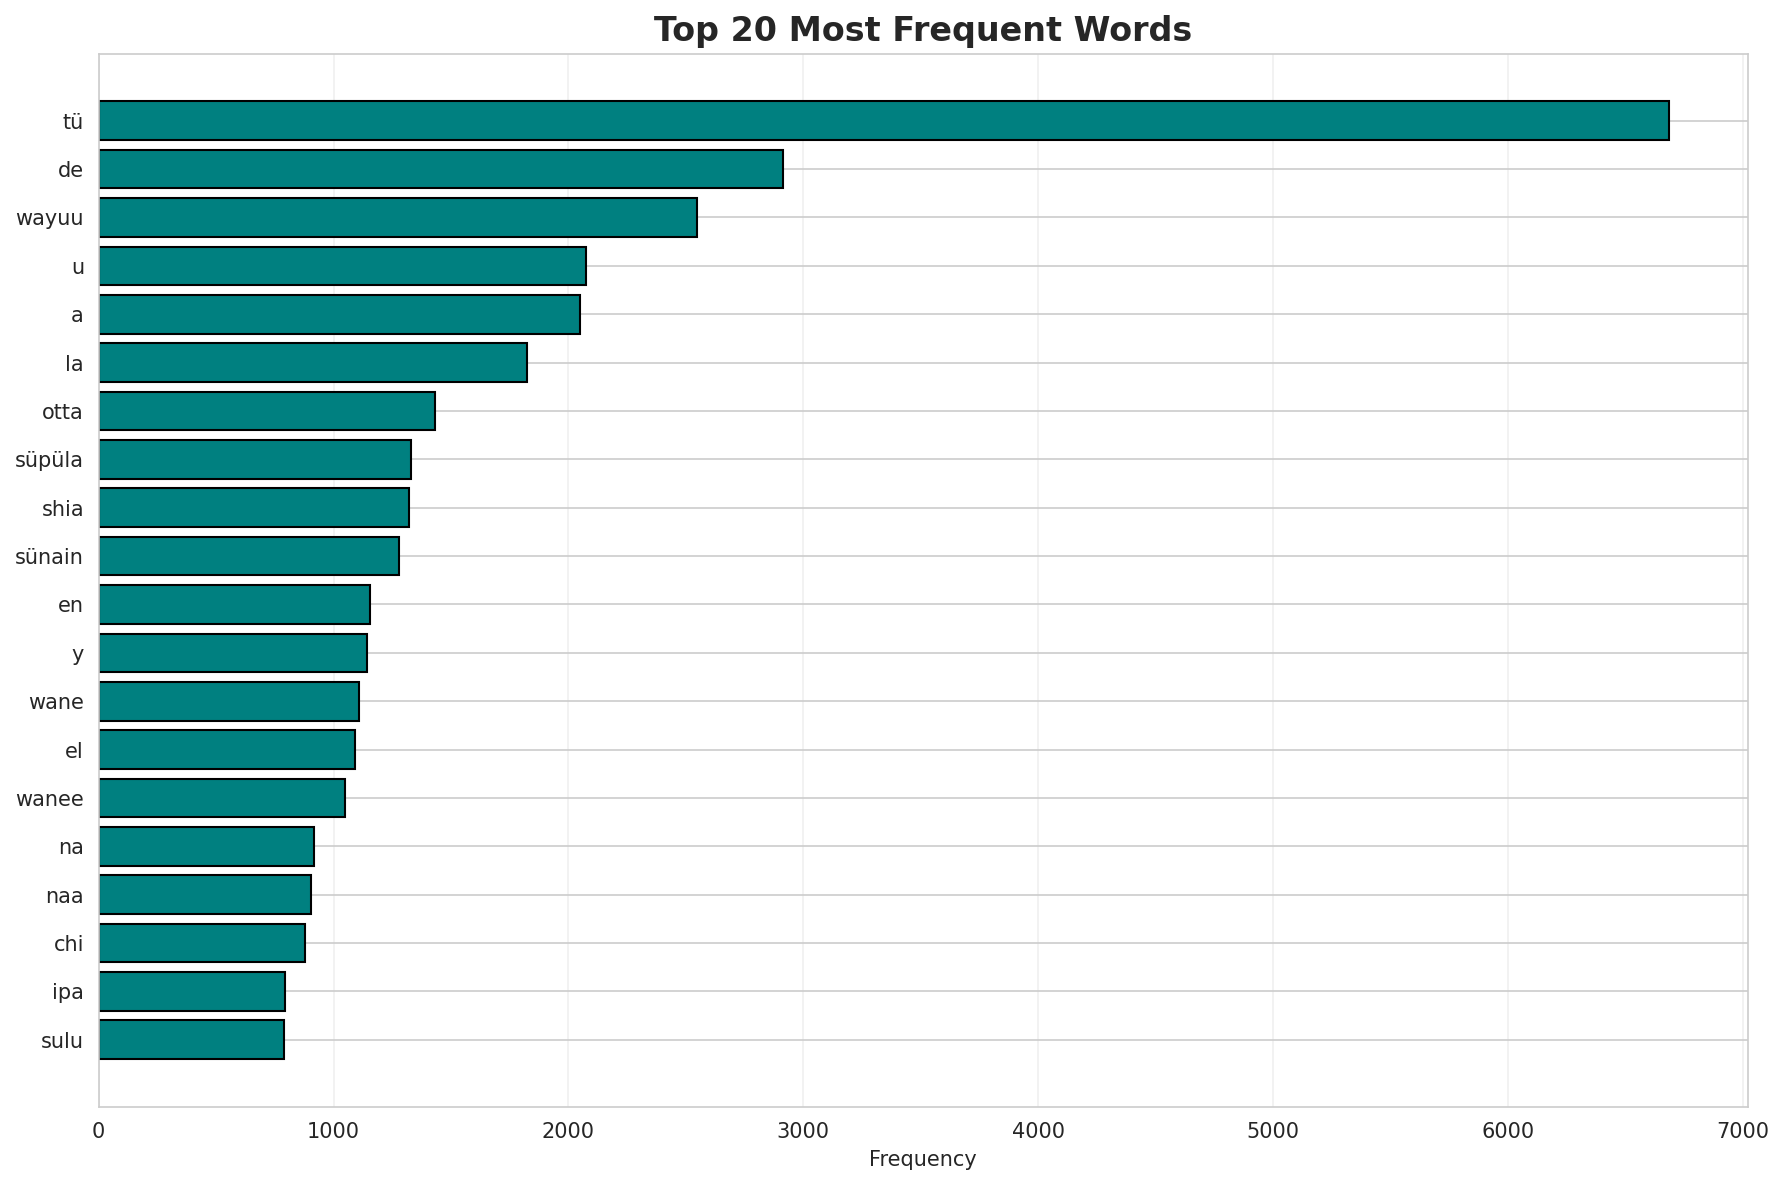
Download visualizations/top20_words.png from wikilangs/guc: direct link, hf CLI and curl.
- Browser
- Download file 51.7 kB
-
https://huggingface.co/wikilangs/guc/resolve/main/visualizations/top20_words.png
- Command line
-
hf download hf://wikilangs/guc/visualizations/top20_words.png
-
curl -L -o top20_words.png https://huggingface.co/wikilangs/guc/resolve/main/visualizations/top20_words.png
51.7 kB